2026-08-28
在这样的背景下,乐聚选择在8月26日发布并开源KUAVO-VLA垂域模型,直面行业反复学习这一现实痛点。把大量真机踩坑换来的经验做成一套可复用方案,为人形机器人真正走进车间,提供了一份极具实用价值的解决方案。
跳出通用模型内卷,乐聚找到落地的关键中间层
通用大模型见多识广,看得懂五花八门的场景,却未必熟悉眼前这台机器人的 “身体”。通用基座训练融合了各式各样机器人的数据,直接搬到真机上,它还要重新熟悉自己的胳膊、关节,摸透自身运动的边界。
放到工厂现场,短板就显得更短了。面对全新工位,机器人不光要学习物料、工序,还要重新认识自己的本体。一旦产线、工件发生变化,不少适配工作几乎等于推倒重来。大量精力消耗在重复适配中,项目很难从个案复制铺开。
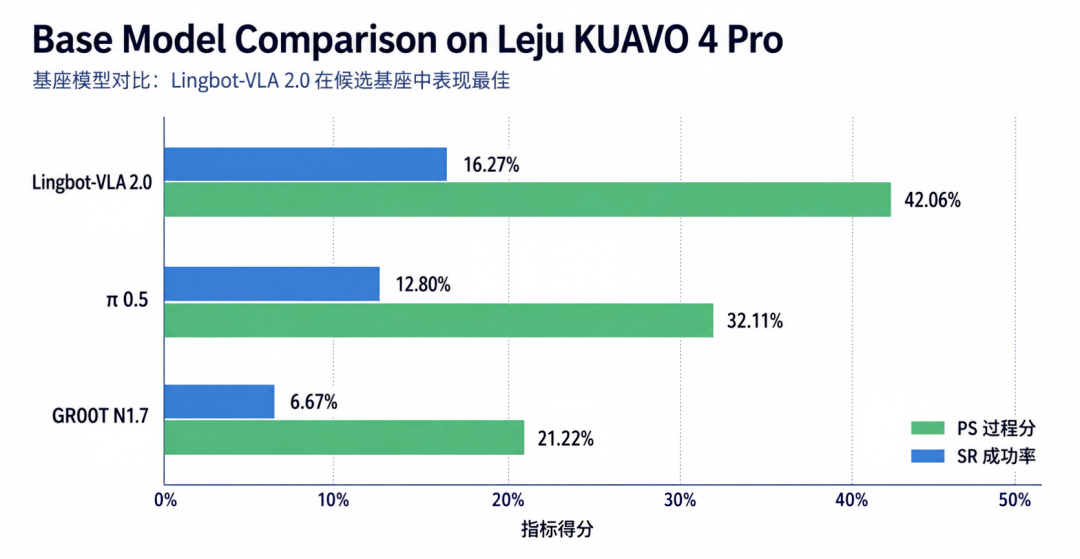
乐聚的解题思路是,不去参与大模型参数竞赛,而是在通用基座和实际作业之间,搭建起一层垂域能力。经Benchmark对比,LingBot-VLA 2.0在参测模型中综合表现最优,因此被选为KUAVO-VLA的能力基座,为其提供更高的通用能力起点。
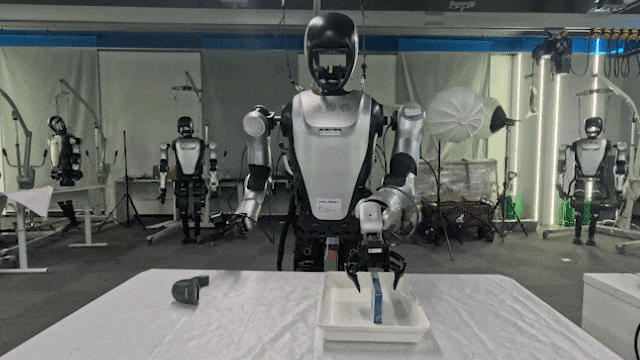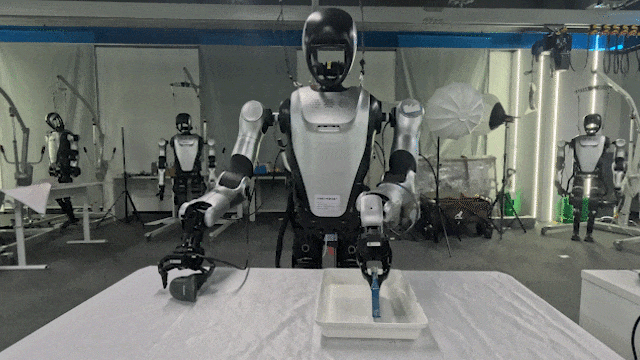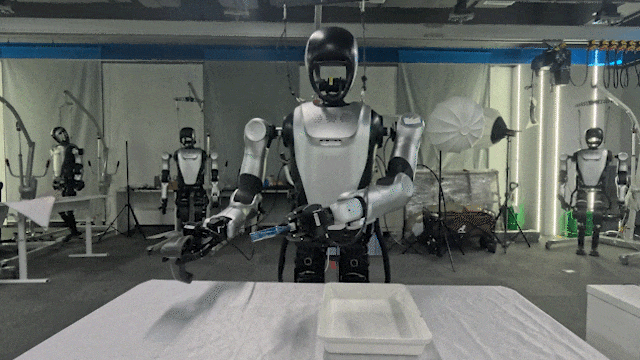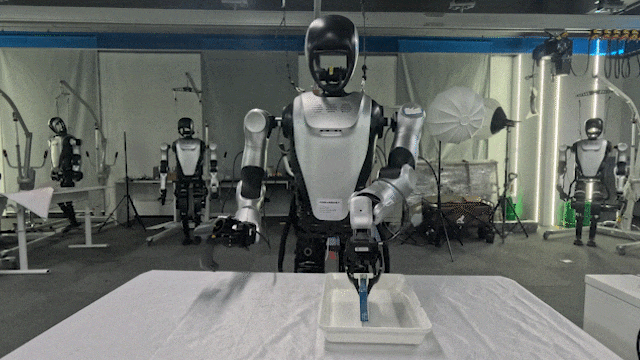
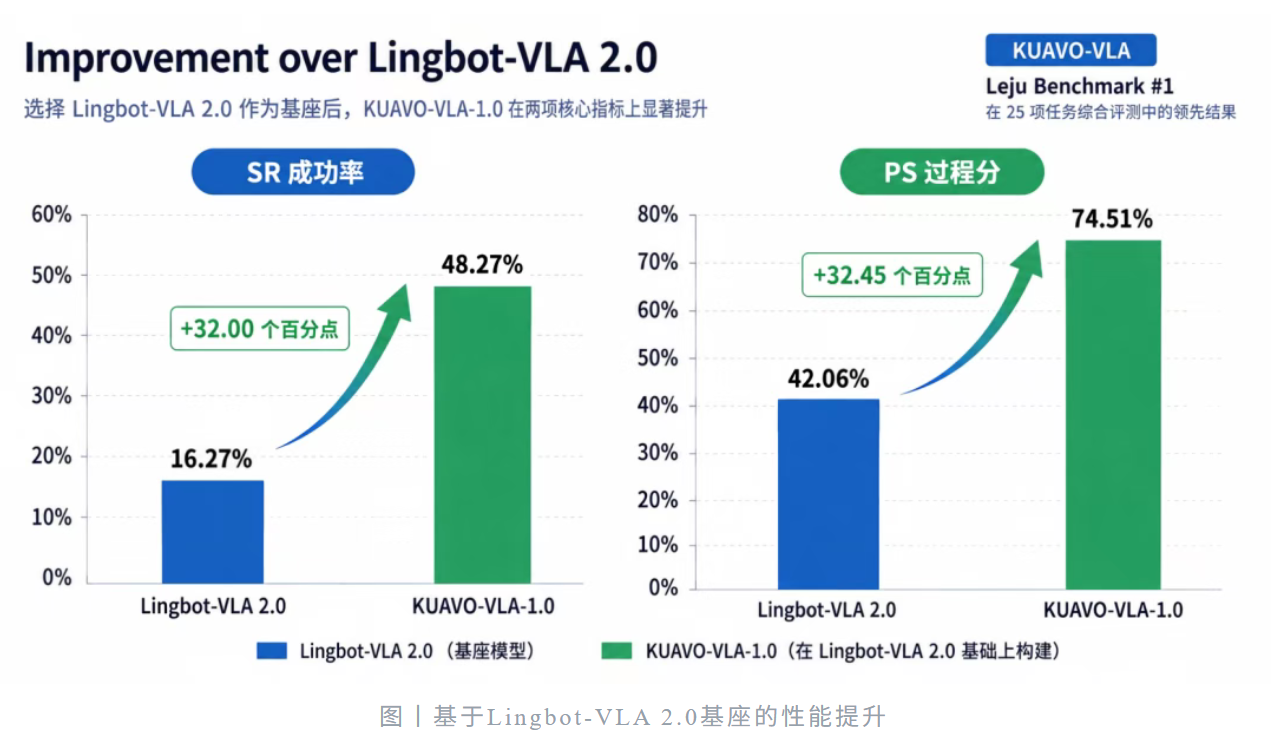 实测结果是流水线开关分拣任务,仅靠5小时示范数据,就能拿到80%的成功率。


GM100零食分拣场景下,150条示范数据便可实现73.33%成功率。真机运行中最直观的感受是,机器人动作抖动、来回修正、反应延迟的现象明显变少,运行起来更像一名熟练的操作工。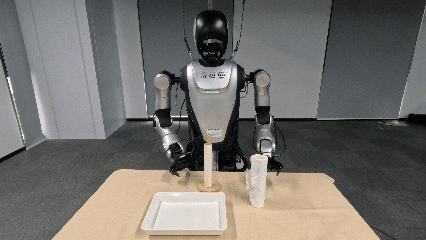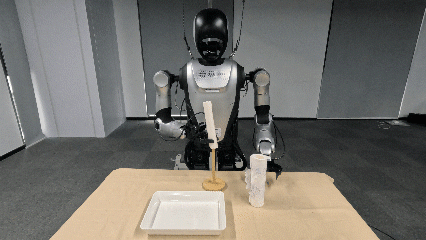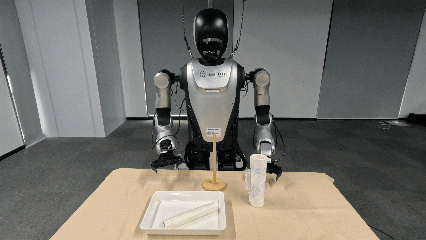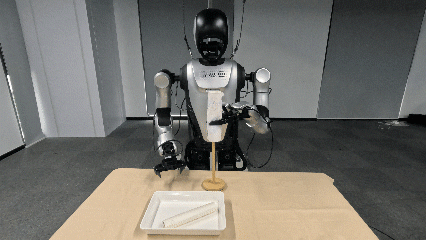



模型只是表象,真机数据能力才是这套方案能跑通的根基
对外而言,KUAVO-VLA是一套亮眼的算法模型。不少团队都能想出相似算法思路,但难点在于真机数据的持续沉淀与优化。
网络上的视频图像素材,替代不了工厂真实工况产出的数据。大量混杂不同机器人本体的训练信息,也让模型陷入类似本山大叔在小品《心病》自嘲的处境——知识学杂了,反而对目标本体形成学习的干扰。
乐聚通过自建训练场与工具链,还原车间真实环境,收录零件公差、光线变化、工位偏移等现实场景问题,以此应对落地中的三大痛点:避免本体重复适配、补齐工业基础操作、缩短新项目开发周期。
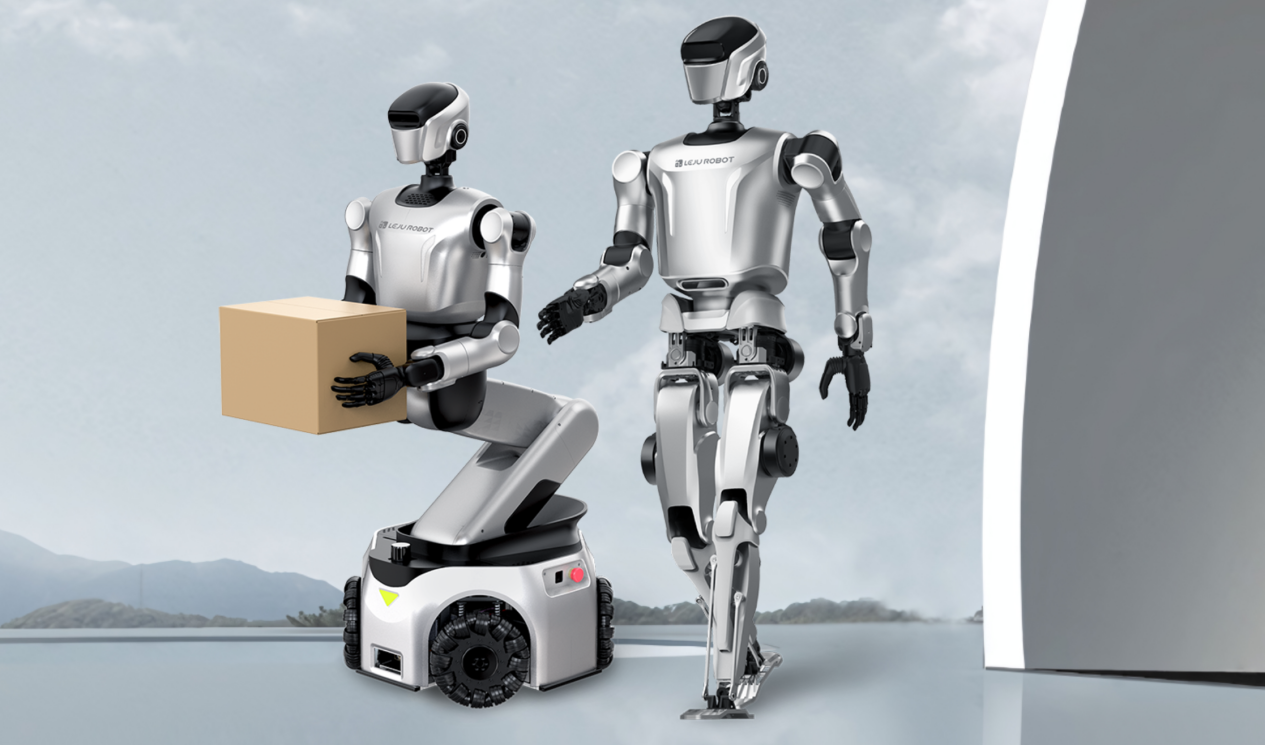 一线项目的真机数据可以回流优化模型。现场积累的实操经验,不会局限在单个项目里,能够复用给后续任务,形成正向迭代。
这套靠硬件采集现场真实数据、沉淀跨项目共性能力,来降低重复学习成本的思路,和Momenta R6的数据飞轮有异曲同工之处,不直接拿通用基座对接业务,先用真机样本完成预训练,新任务只需适配差异化部分。
在此基础上,乐聚把模型、代码、数据集在OpenLET、ModelScope、HuggingFace等平台开源。开源的意义不只是放出模型文件,更是共享工业现场打磨出的实战经验,帮助开发者减少试错成本。
提供分工范本,给全行业带来启发
客观来讲,KUAVO-VLA解决的更多是软件层面 “重复造轮子” 的痛点。本体硬件性能上限、产线严苛的生产节拍、高度非标复杂工况,依旧是整个行业共同要翻越的大山,但它扫清了人形机器人规模化路上最棘手的一重阻碍。
垂域模型不等于拿来就能直接开工上岗,落地真实工位,依旧需要针对性的后训练适配。
过去行业热衷于全栈自研,不少企业希望包揽基模、本体、工艺落地全部环节。可一家公司的精力终究有限,全链条负重前行,很难把每一块都做到尽善尽美。
乐聚这套 “通用基座-垂域中训练-现场微调” 的实践,顺带理清了不同角色的分工:基模厂商负责打造广泛通用的底层能力;机器人平台完成本体适配,沉淀行业共性本领;集成服务商扎根现场,完成工位落地调试,大家各司其职,减少无效重复劳动。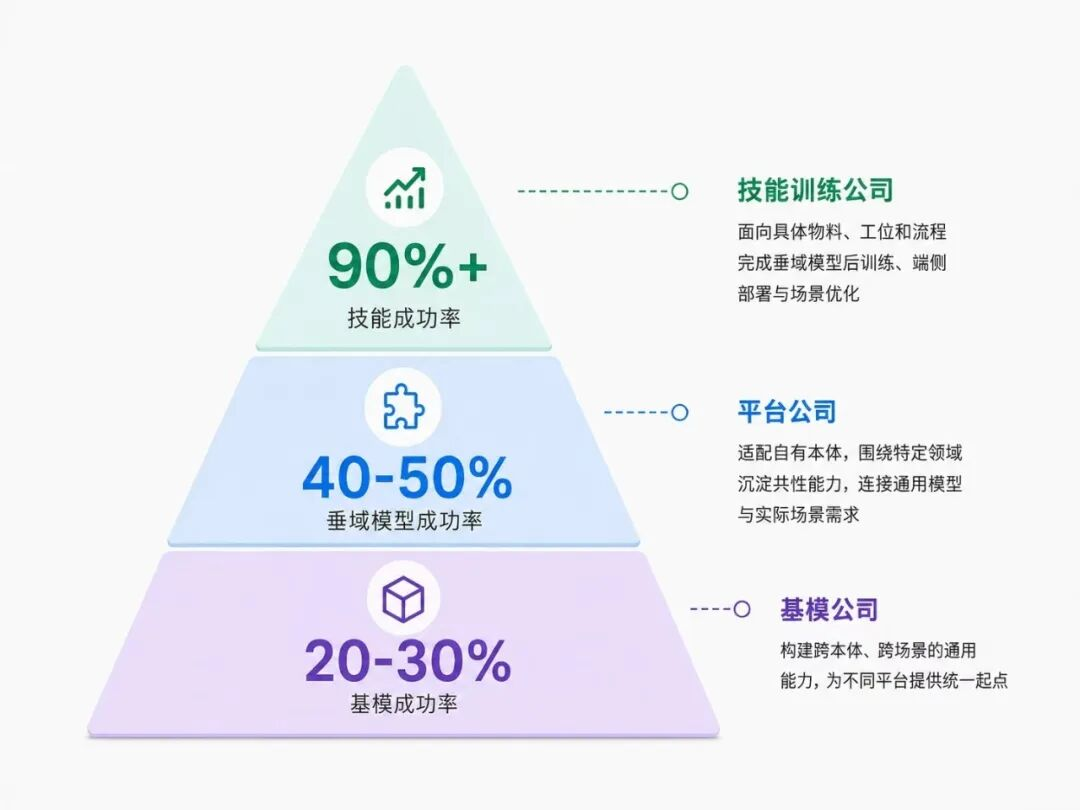 这也在提醒行业,评判人形机器人好坏,不能只看展台上精彩一瞬。真正有价值的指标,是上新工位要花多少时间、多少人力、多少数据。开源的选择,进一步放大了这套分层思路的示范意义。
结语
行业总在说人形机器人已经告别展台演示,可是真的能 “体面” 说再见的并不多,不少还得 “接着奏乐,接着舞” 一阵。KUAVO-VLA的价值,远不止是一份垂域模型。它是经过大量真机调试、现场试错,摸索出来的一条落地路径。
乐聚用实际项目验证了垂域路线适配工业场景的可行性,给人形机器人落地工厂提供了可复用的实践样本。后续伴随更多产线跑通,这套方案的价值还会持续释放。