2026-08-28
今天早上,我本来在写一篇关于机器人行业融资遇冷的稿子,主题是"具身智能距离家庭落地还有多远"。
结果量子位一条推送直接把我的稿子扔进了回收站。
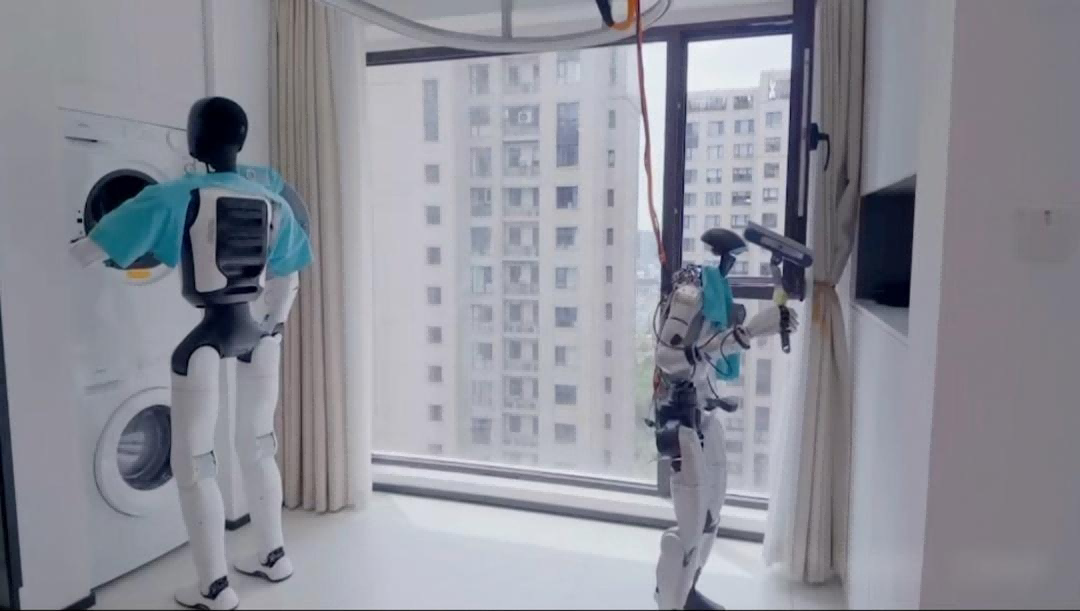
而今天量子位这条视频里的机器人,干的事情简单到不起眼——擦玻璃、收衣服、放东西。但每一个动作的背后,都是自主推理、实时决策、环境交互和长期任务规划。
这才是真正难的地方。
更让行业窒息的是,这条视频的环境设计。
拍摄场地是一个15平米左右的出租屋,家具密集,过道狭窄,连人转身都费劲。这种环境,基本排除了遥操作的可能性——因为根本站不下人。
同时,一镜到底的长视频,意味着没有剪辑,没有重拍,没有"把失败的镜头剪掉"。
而且两个机器人全程在同一个空间里并行干活,没有碰撞,没有迷路,没有停滞。
如果这是提前预设的脚本,那这个脚本的复杂度会高到无法工程实现。因为任何一个小误差——比如机器人多走了两厘米,或者物品放歪了一点——都会在这条长视频的长链条里被无限放大,最终导致整个演示崩盘。
所以,这只能是一条完全自主学习、自主进化、自主决策的视频。
环境是陌生的,任务是复杂的,时长跨度长,中间还有闹钟打断、任务切换、跨本体协作这些"地狱级"难度加成。
换作市面上任何一款已知的具身模型,能撑过前两分钟就算不错了。
而这个神秘模型,不仅撑过了整条长视频,还在这个过程中展现出了至少七八个"行业首次"。
每一个单拿出来,都够一家具身智能公司开一场发布会。
但它就这么静静地出现在一条一镜到底的长视频里,好像这些能力都稀松平常。
这种"信手拈来"的轻松感,才是真正让人后背发凉的地方。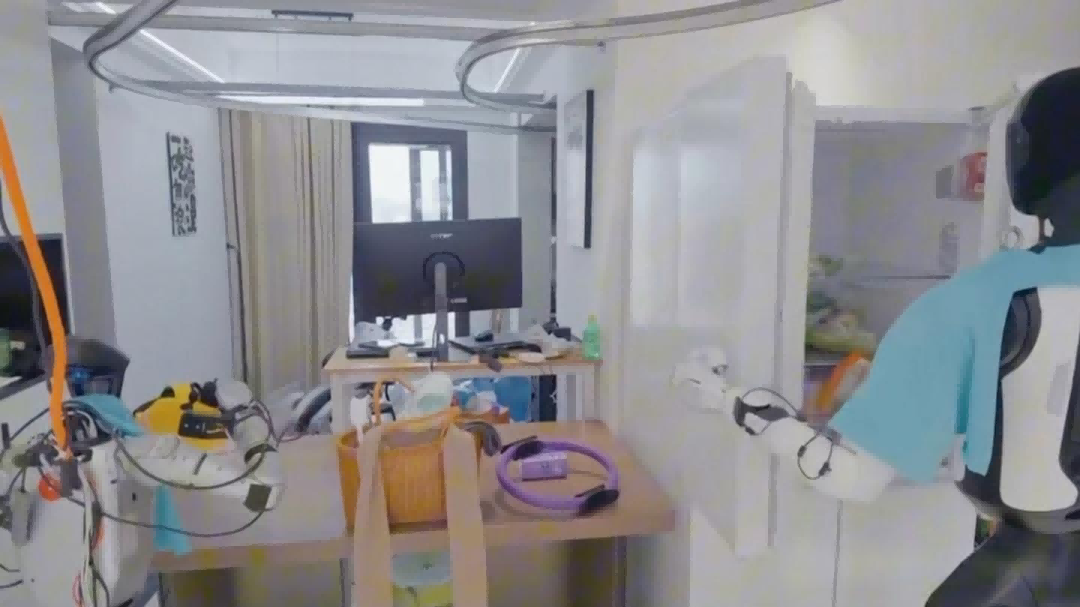
视频的第一个任务,就让我坐直了。
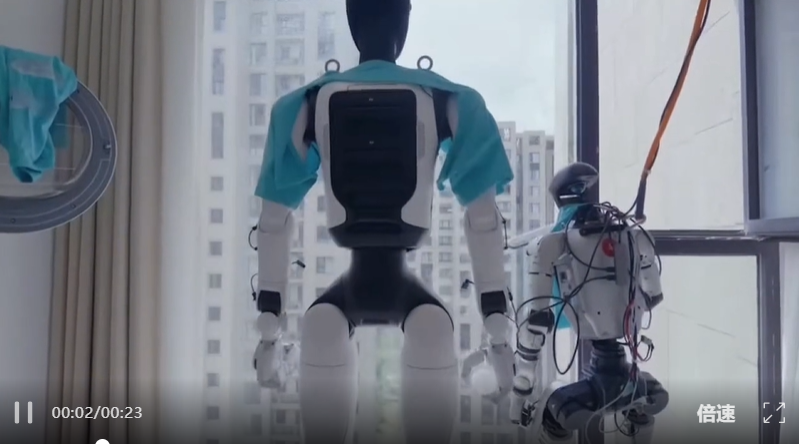
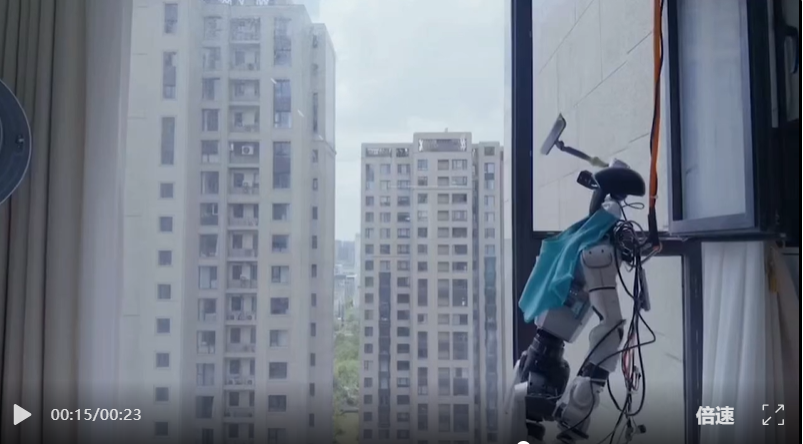
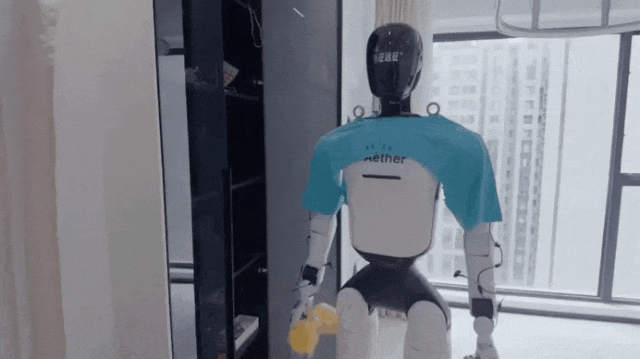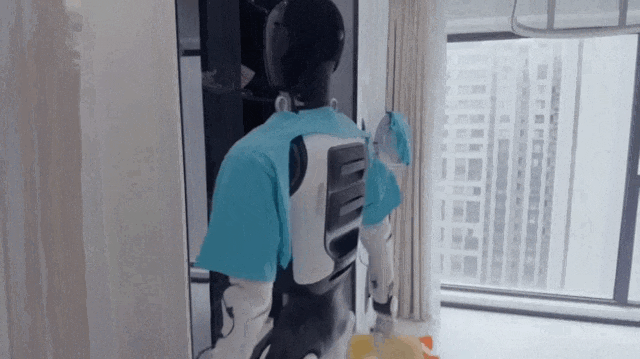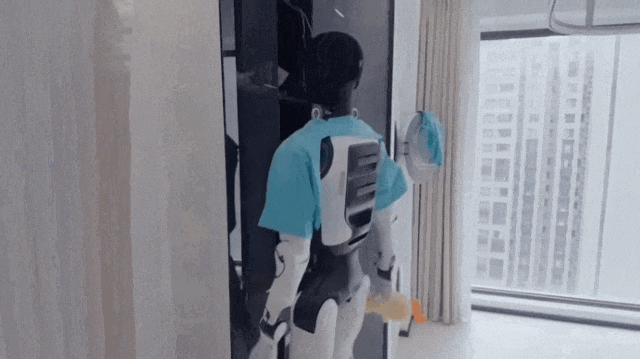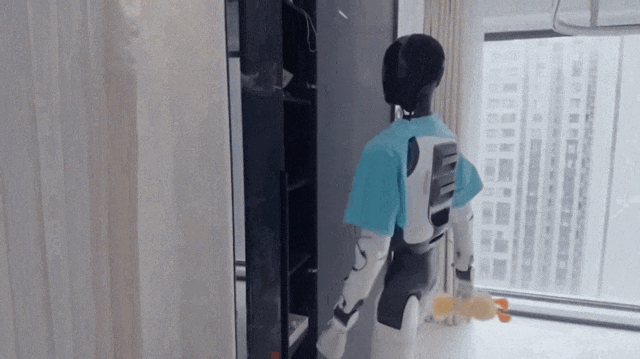
一台宇树G1机器人拿着一把刮水器,开始擦玻璃。
这个任务的选择本身就极其"恶意"。为什么?因为刮水器是擦玻璃工具里,对力度和角度要求最高的一种。用抹布擦,力大点小点无所谓,擦不干净可以多擦几遍。但刮水器不一样——力小了,水渍刮不掉;力重了,胶条和玻璃之间会发出刺耳的异响,而且可能刮坏胶条。
用过刮水器的人都知道,人类掌握这个工具都需要一定的练习。机器人上来就拿刮水器擦玻璃,这属于"新手村直接打Boss"。
更关键的在于,擦玻璃这个动作,对机器人的力学建模能力提出了极高要求。刮水器与玻璃之间是一个动态接触面,力的传递不是简单的点对点,而是沿着胶条方向分布。机器人需要实时感知刮水器与玻璃的接触状态,调整施加的力度和角度,保证擦拭效果的同时不损坏工具。
这背后,是精确到牛顿级别的力矩控制,是毫秒级别的触觉反馈,是对刮水器形变特性的动力学建模。
现有的具身模型,能把力控做到这个程度,已经是行业天花板。
但真正让我反复回看的,是接下来的一幕。
机器人擦了几下,发现有一处脏东西始终擦不干净。
注意,这里有个细节:它没有继续用更大的力气去擦同一块区域。这是绝大多数机器人的做法——重复同一个动作,直到任务超时或者被判定失败。
宇树G1没有。它停了下来。然后做出了一套我从来没有在机器人身上见过的动作序列:
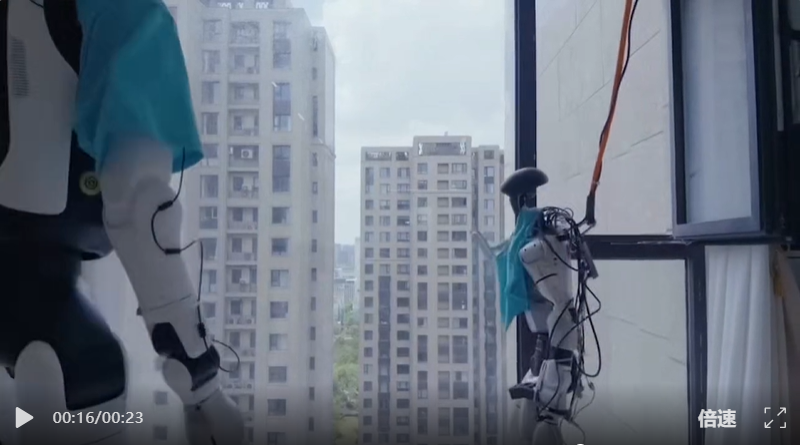
侧身、后仰、探头、展臂,把拿着刮水器的手伸出了窗外。
整套动作流畅得像一个站在窗边擦玻璃的老手。
而且请注意一个关键细节:它伸出手的时候,没有碰到窗框。
这意味着什么?意味着机器人在执行这个动作之前,已经完成了对窗户开口大小的精确空间建模,知道自己的手臂穿过窗户时不会撞到边框。它对自己手部尺寸的认知、对窗户开口的感知、对两者之间空间关系的计算,是在动作执行之前就已经完成的。
这是空间感知、本体认知和动力学解算的三位一体。
但这还不是最恐怖的。最恐怖的是它的推理逻辑。
让我们还原一下这个机器人脑子里(如果它有)发生了什么:
"我擦了这块玻璃,但有一处脏东西擦不掉。脏东西在玻璃的这一面擦不掉,那它可能不在这一面,而是在另一面。窗户外面是我看不到的地方,但如果我把手伸出去,从外面擦,可能就能擦掉了。我的手臂够长吗?窗户开口够大吗?计算完毕,可行。执行。"
这个推理链条,是人类才会有的因果推理。
它不是基于训练数据里的"当擦不干净时,尝试把手伸出窗外"这种模式匹配。因为没有任何训练数据会包含这种场景。这是模型在面对一个从未见过的问题时,自主生成的解决方案。
这种能力,在具身智能领域有一个专门的名字:泛化推理。
而泛化推理,一直被认为是VLA模型最大的短板。
现有的VLA模型,本质上是"看图猜动作"。它们学到了"当看到玻璃上有一个污渍时,应该用抹布去擦"这种条件反射。但一旦场景发生微小变化——比如污渍在窗外,或者没有抹布只有刮水器——模型就会直接失效。因为它的所有能力,都被训练数据锁死了。
而这条视频里的模型,面对的是一个它从未见过的具体情境:刮水器+玻璃+污渍+窗外+手臂长度+窗户开口大小。
这个组合,几乎不可能出现在训练数据里。但它依然给出了最优解。
这就是从"条件反射"到"真正思考"的跨越。
对于具身智能行业来说,这个跨越的意义,怎么强调都不为过。
因为在此之前,行业里有一个普遍的悲观共识:VLA模型的能力上限,就是训练数据的天花板。你永远不能指望一个只见过"擦桌子"的机器人,能自主学会"擦玻璃"。
而今天这条视频,用一只伸出窗外的手,把这个共识打碎了。
图源:量子位
聊完了细节,我们来认真说说,这个模型为什么能做到这些。
根据量子位文章的分析,这套模型跳出了当前所有主流具身模型的技术框架。
要理解它的牛逼之处,我们先要理解现阶段主流模型的"不行之处"。
目前市面上的具身模型,大致可以分为三类:VLA模型、WAM模型、传统世界模型。
VLA(Vision-Language-Action)模型,是当前最主流的一派。它的思路是:把机器人看到的东西(视觉)和任务指令(语言)输入到一个端到端的神经网络里,然后直接输出动作。听起来很美好。但VLA的本质是"看图猜动作"。它做的所有事情,都是基于训练数据里的统计规律。看到一块玻璃上有污渍,就输出"擦"的动作。这个动作是训练数据里最常出现的对应动作。
问题在于:统计规律不是物理规律。 VLA模型不理解重力,不理解摩擦,不理解力的传导,不理解空间几何。它只是在数据里见过足够多次"玻璃+污渍→擦"的组合,所以能做出看起来合理的动作。一旦场景变了——污渍在窗外,或者没有抹布只有刮水器——VLA就废了。 因为训练数据里没有这个组合,它就"猜"不出来该做什么。
WAM(World-Action Model)和传统世界模型,走的是另一条路。它们试图先让模型理解世界,再基于对世界的理解来规划动作。听起来比VLA高级,但实际效果并不好。因为它们的"理解",本质上还是统计预测。它们预测"如果我做这个动作,画面会变成什么样"。但"预测画面"和"理解物理"之间有巨大的鸿沟。
一个机器人可以在模拟器里预测"杯子掉到地上会碎",但当它在现实中拿起一个杯子时,它依然不知道应该用多大的力握持,因为"预测画面"不包含力的维度。
VLA是"数据直觉派",WAM是"预判空想派"。 两者有一个共同的底层缺陷:数据驱动的任务拟合。所有的能力,都来自对训练数据的拟合。所有的动作,都是对数据分布的采样。这意味着,模型的能力上限,就是训练数据覆盖的空间边界。
而这条视频里的模型,据说只用了几十个小时的视频数据训练。几十个小时。不是几万小时,不是几百万条轨迹。是几十个小时。就这么点数据,它做到了那些用了几千万条数据训练的模型做不到的事情。
所以它一定不是在"拟合数据"。它是在"理解物理"。
根据量子位的分析,这套模型的三个核心技术内核是:
第一,物理约束动力学学习。 不像VLA和WAM那样纯数据驱动,它的核心是物理规则前置、动力学预测驱动。模型内部嵌入了对重力、摩擦、接触力学、刚体运动学的基本约束。在这个基础上,它再学习如何操作物体。所以它不需要"见过"刮水器擦玻璃,它只需要理解"力如何通过刮水器传导到玻璃表面",就能自主生成擦拭动作。
第二,跨本体统一建模。 通过统一的动作表示空间和本体自适应机制,让同一套模型适配不同品牌、不同架构的硬件平台。模型对"手"的理解,不局限于某个特定型号的机械手,而是抽象到了"操作末端"的层面。所以宇树的手和智元的手,在它眼里是同一个概念的不同实例。
第三,长时序鲁棒闭环。 依托全局任务调度框架,自主处理全程突发干扰、动作误差、任务切换。模型对任务的理解不是在执行一个动作链,而是在维护一个任务状态机。它知道当前整体任务的进度,知道每个子任务的状态,知道如何在必要时暂停、切换、恢复。
这三个技术内核,每一条都像是对当前具身智能行业主流技术路线的一次正面宣战。
但更重要的是,它颠覆了Scaling Law的叙事。
过去几年,整个AI行业都在被Scaling Law统治:数据越多,参数越大,能力越强。具身智能领域也不例外,大家都在拼命堆数据、堆算力。
但如果一条只用了几十小时数据的模型,就能达到甚至超越那些用了千万级数据的模型——
那Scaling Law在具身智能领域,还成立吗?
这个问题,足以让英伟达的股价抖三抖。
做科技媒体这些年,我见过太多"行业时刻"被提前宣布。
"自动驾驶即将普及""VR是下一个计算平台""元宇宙改变一切"……每一个都在当时看起来无限接近,但事后回看,都差了那么一口气。
所以我对"新时刻"这个词的使用,一直极度克制。
但今天,我不得不承认:具身智能的行业时刻,真的来了。
不是因为这条视频多么精致——恰恰相反,它粗糙得像监控录像。而是因为,它展现出来的能力集合,已经远远超出了"实验室演示"的范畴,开始触及真实家庭的真实需求。
我们来数一数,这条一镜到底的长视频,展示了哪些家庭生活必需的能力:
擦玻璃——不是随便擦擦,而是会判断脏东西在哪一面,会把手伸出窗外擦干净。这项能力对应的是家庭清洁中最高频也最让人头疼的场景之一。
收纳整理——把洗好的坐垫放回沙发,把玩偶放进衣柜,把衣服放回原位。这是家务中重复性最高、最消耗耐心的部分。
冰箱管理——看到冰箱上有食物,判断应该冷藏储存,主动放进去;顺便拿出应该解冻的食物。这不仅需要识别能力,还需要生活常识。冷藏、冷冻、解冻,这些概念对机器人来说,是真正的知识门槛。
衣物分拣——判断搭在洗衣机上的是脏衣服,放进去洗。这意味着机器人理解了"洗衣服"的完整闭环:脏→洗→净→收纳。
使用工具——够不到高处时,自己找箱子垫脚。这是超越"执行任务"的自主问题解决能力。
协同作业——两个不同品牌的机器人,自主分工,互相帮忙,完成一个人没法完成的任务。这对应的是家庭中那些需要"搭把手"的场景。
断点续做——被闹钟打断后,能切换任务,再恢复原任务。这对应的是家庭中永远存在的"突发事件"。
省力策略——毛巾挂肩上,拖鞋拎挂绳。这看起来像"偷懒",实际是对效率的极致追求,意味着机器人可以在家长时间自主运行而不用频繁充电。
当我把这些能力列出来的时候,我意识到一件事:
一个具备以上所有能力的机器人,已经可以在我的家里,替我完成至少70%的日常家务了。
不是未来。是现在。
这就是为什么我说"机器人无痛进家做家务真的实现了"。
"无痛"这个词,是关键。过去我们讨论机器人进家,最大的障碍不是能力,而是信任。你不放心让一个笨拙的机器人靠近你的花瓶,你不放心它在你的孩子旁边走动,你不放心它把东西打翻之后不知道怎么办。
而这条视频里的机器人,展现出的空间感知精度(手臂穿过窗户不碰边框)、力度控制能力(擦玻璃恰到好处)、环境适应能力(狭小空间无碰撞)、错误恢复能力(从摔倒的边缘自救)——都在一步一步建立人类对它的信任。
当然,目前这个模型的团队还是未知的,这段视频的真实性也需要业内的进一步验证。但即便我们保守地打一个折扣,它展现出的能力也已经远超行业的普遍认知。
这就是"行业新时刻"的定义:它不是某个技术的完美成熟,而是所有人突然意识到,"原来还可以这样"。
在这条视频之前,具身智能的创业者和投资人讨论的问题是:"怎么让机器人做好一个简单的抓取任务?"
在这条视频之后,问题变成了:"怎么追上这个神秘团队?"
问题变了,时代就变了。
原因很简单:机器人离普通人的生活太远了。 语言模型有键盘,你打开网页就能用。但机器人需要你花钱买硬件,需要你给它一个物理空间,需要你容忍它在你面前试错。
如果机器人不够好,你永远不会让它进你的家门。
而今天这条视频展示的,是一个已经足够好到让人动心的程度。好到你会想:"如果这个东西现在就能买到,我会不会买?"
我的答案是:会。
即便它有时候会犯错,即便它可能不如视频里那么完美。但它展现出的能力下限,已经超过了大多数人对家务机器人的预期上限。
当"不错"变成了"太好了,我什么时候能用上",技术就过了临界点。
而这个临界点,就是商业化的起点。
所以,我在这里做一个预测,大家可以在评论区留个记录,三年后回来看:
未来12-18个月之内,我们会看到至少3-5个中国团队,发布能在家庭环境中自主执行多任务家务的机器人产品。
未来24-36个月,机器人走进普通家庭的速度,会像当年的智能手机一样,超出所有人的预期。
而今天量子位发布的这条视频,将被追认为这条曲线的起点。
当然,前提是这段视频经受住业内的检验。但从我的直觉来看,一个能拍出这种视频的团队,不需要造假。因为他们已经把技术做出来了,现在要做的,只是让世界看到。
这篇稿子我从早上写到了下午,中间停了三次,每次都是因为看视频的某个片段看出了神。
不是因为这条视频有多震撼人心——它不精致,不华丽,甚至有些无聊。
而是因为,它太像真的了。像一个普通的家庭,一个普通的下午,两个机器人在安静地做家务。一切都那么自然,自然到让人忘记了,这背后是一整套足以改写行业格局的底层技术。
最了不起的技术,是让人感觉不到技术的存在。
而这条一镜到底的长视频,做到了。
擦玻璃的手伸出窗外,闹钟响了停下来,把毛巾挂肩膀上,用脚踹箱子,两个机器人互相配合。
这些画面的背后,是空间感知、自主推理、跨本体建模、长时序规划、工具使用、群体智能……
每一个词,都是具身智能领域的圣杯。
但在这条视频里,它们以最朴素的方式呈现。就像学霸解题,一步步写下来,你觉得理所当然。但你自己去做,才发现每一步都难如登天。
这就是王者的从容。
最后,用一句话来结束今天这篇稿子:
以前我们讨论机器人什么时候能进家。今天之后,我们该讨论的是,谁家的机器人先进家。
而那个神秘团队,可能此刻正在看着这条视频的评论区,笑而不语。
你们到底是谁?出来聊聊吧。